Fundamentos de los LLMs
Soy Ingeniero de Software con más de 10 años de experiencia. Después de pasar por gigantes como UBER estamos intentando mejorar el mundo de los seguros como desarrollador de Backend.
Objetivo: entender qué sucede cuando una aplicación envía información a un Large Language Model (LLM), qué puede hacer el modelo y cuáles son sus limitaciones.
1. ¿Qué es realmente un LLM?
Un Large Language Model es un modelo de inteligencia artificial entrenado para procesar y generar secuencias de tokens.
Durante su entrenamiento aprende patrones estadísticos del lenguaje, relaciones entre conceptos, estructuras de documentos y muchas otras regularidades.
Cuando recibe una entrada, genera una respuesta prediciendo sucesivamente los tokens que siguen, basandose en el contexto disponible.
Esto parece sencillo, pero permite comportamientos complejos: resumir, traducir, clasificar, razonar sobre problemas y extraer información.
Una aclaración importante: un LLM no funciona como una base de datos tradicional. Puede generar respuestas que contienen información incorrecta.
Ejemplo de nuestro proyecto de extraccion financiera
Imagina que le enviamos este texto:
Estado de cuenta — Octubre 2026
01/10/2026  OXXO       -150.00
02/10/2026  NOMINA   +25000.00
03/10/2026  AMAZON    -850.00
Despues le pedimos al LLM que las identifique y nos devuelve esto:
[
  {
    "date": "2026-10-01",
    "description": "OXXO",
    "amount": -150
  },
  {
    "date": "2026-10-02",
    "description": "NOMINA",
    "amount": 25000
  },
  {
    "date": "2026-10-03",
    "description": "AMAZON",
    "amount": -850
  }
]
El modelo sabe como identificar fechas, montos , descripcion PERO eso no garantiza que siempre extraiga correctamente los tres movimientos. Recordemos esto es probabilidades .
Veamos ahora los conceptos mas básicos cuando trabajamos con LLMs.
2. ¿Qué son los tokens?
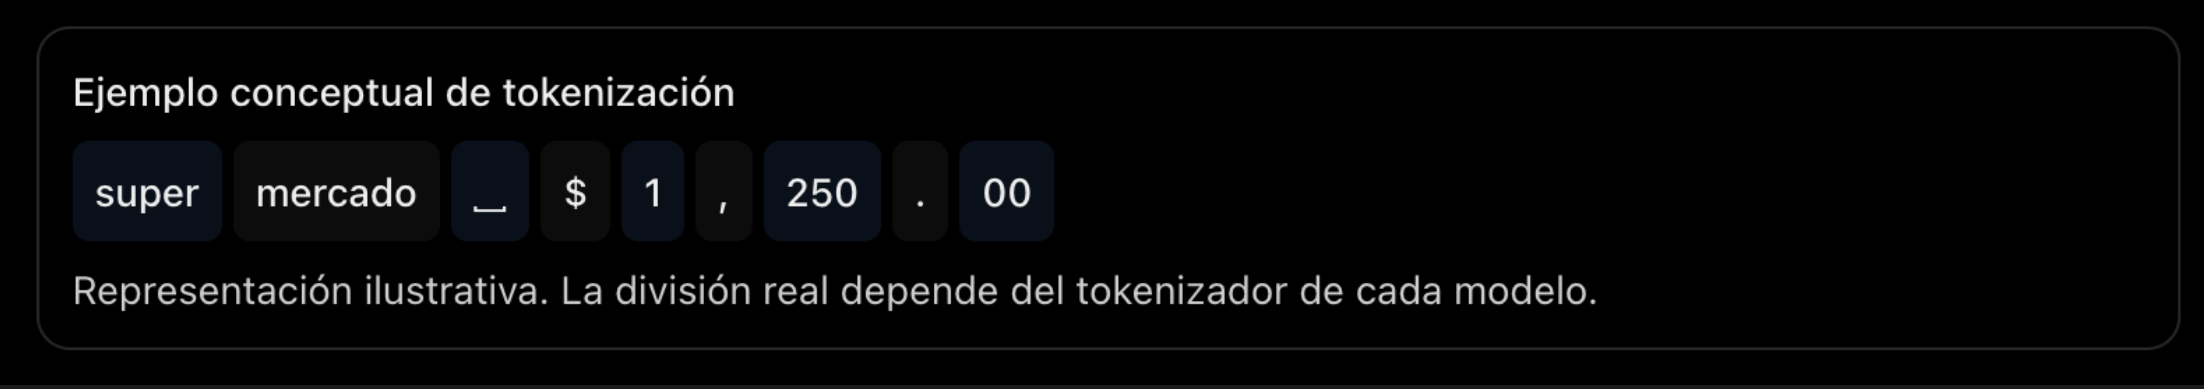
Los LLMs NO procesan directamente palabras completas como unidades fundamentales. Procesan tokens.
Un token puede representar una palabra, parte de una palabra, signos de puntuación o fragmentos de números.
Ejemplo conceptual de tokenización
¿Por qué importa?
Porque el número de tokens influye en:
Costo: muchas APIs cobran según los tokens de entrada y salida.
Latencia: generar más tokens de respuesta generalmente requiere más tiempo.
Capacidad: cada modelo tiene un límite de contexto.
3. ¿Qué es la ventana de contexto?
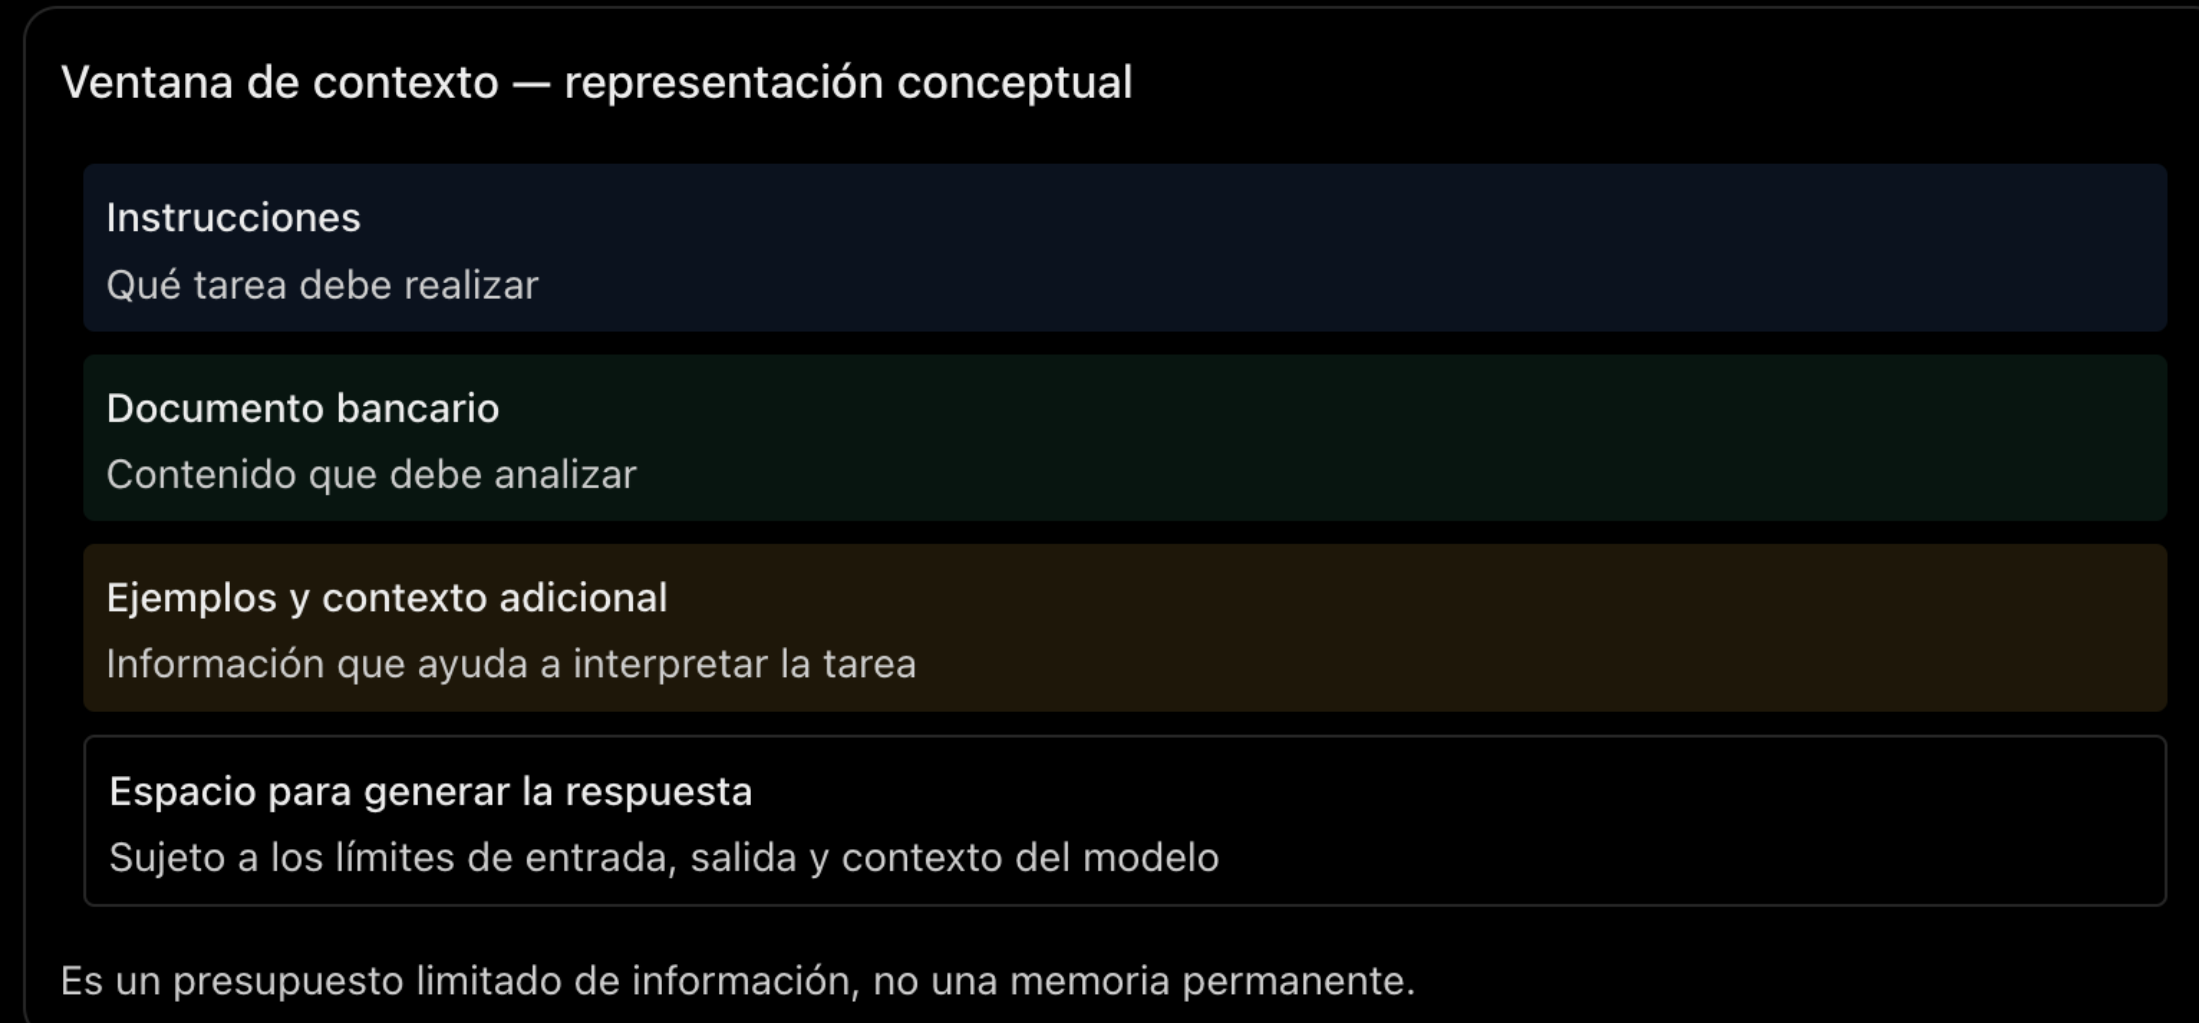
La context window es la cantidad máxima de tokens que un modelo puede considerar en una solicitud, según sus límites específicos.
Puede incluir instrucciones, contenido del usuario, mensajes anteriores y otros datos proporcionados al modelo.
Hay dos conceptos que no debemos confundir:
Contexto: información disponible durante una solicitud.
Conocimiento aprendido: patrones incorporados durante el entrenamiento del modelo.
Por ejemplo, el modelo puede conocer el significado general de una transferencia bancaria, pero no conoce los movimientos de tu cuenta de octubre a menos que se los proporciones mediante alguna fuente.
Una limitación importante
Que un documento quepa dentro de la ventana de contexto no significa que el modelo vaya a utilizar toda su información correctamente.
Puede omitir filas, confundir números o interpretar incorrectamente partes del documento.
Más adelante vamos a aprender como evaluar la info que nos devuelve el LLM.
4. ¿Qué sucede cuando llamamos a un LLM desde una aplicación?
Este es el modelo mental que quiero que recuerdes.
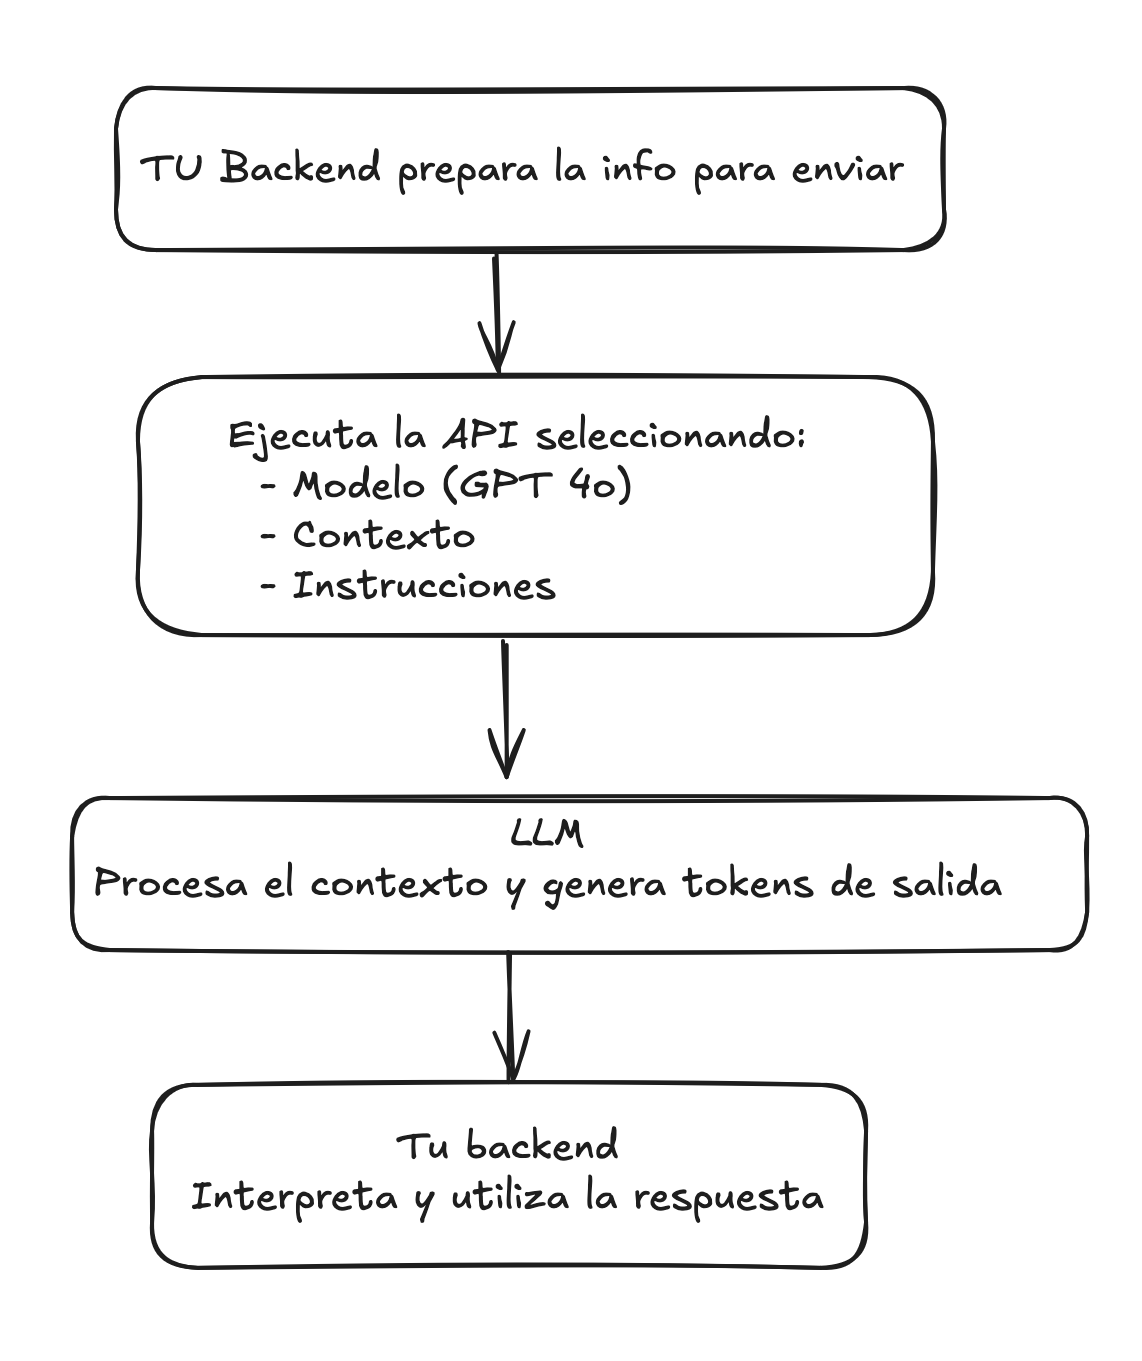
Lo fundamental es que el modelo no reemplaza tu backend.
Tu aplicación sigue siendo responsable de decidir qué enviar, qué hacer con la respuesta y qué datos aceptar cuadno el LLM te responda.
Si quieres practicar esta teoria , aqui esta el repo y las instrucciones con algo de teoría .